Bedeutungswandel in ressourcenarmen Domänen: Computational Humanities und Natural Language Processing im Dialog
Das Erkennen und die Beschreibung von lexikalischem Bedeutungswandel ist eine grundlegende Aufgabe für die Geisteswissenschaften, doch moderne computergestützte Methoden stoßen hierbei auf erhebliche Hindernisse. Große Sprachmodelle (LLMs) sind zwar leistungsstark, erfordern jedoch riesige Trainingskorpora, die in den ressourcenarmen Domänen der historischen und spezialisierten geisteswissenschaftlichen Forschung nicht verfügbar sind. Das begrenzt die praktische Anwendbarkeit und den wissenschaftlichen Wert der in den letzten Jahren erforschten automatisierten Methoden zur Analyse von Sprachwandel.
Die interdisziplinäre Forschungsgruppe SILD (Semantic shifts In Low-resource Domains) wurde konzipiert, um diese Probleme zu überwinden. Durch die Vereinigung von Forschenden aus unterschiedlichen Disziplinen wie Natural Language Processing (NLP), visueller Analytik und Computational Humanities wird SILD neuartige Methoden zur Erkennung von semantischem Wandel entwickeln, die dateneffizient, interpretierbar und auf reale geisteswissenschaftliche Forschungsfragen zugeschnitten sind. Unser Fokus erstreckt sich über Einzelwörter hinaus auf die Analyse von Mehrwortausdrücken (MWE), die entscheidende Träger historischer und kultureller Bedeutung sind. Eine zentrale technische Innovation ist die enge Integration von LLMs mit strukturiertem Domänenwissen (z. B. aus historischen Wörterbüchern), das in Wissensgraphen (KGs) repräsentiert wird, um Sprachrepräsentationen in datenarmen Umgebungen zu verbessern.
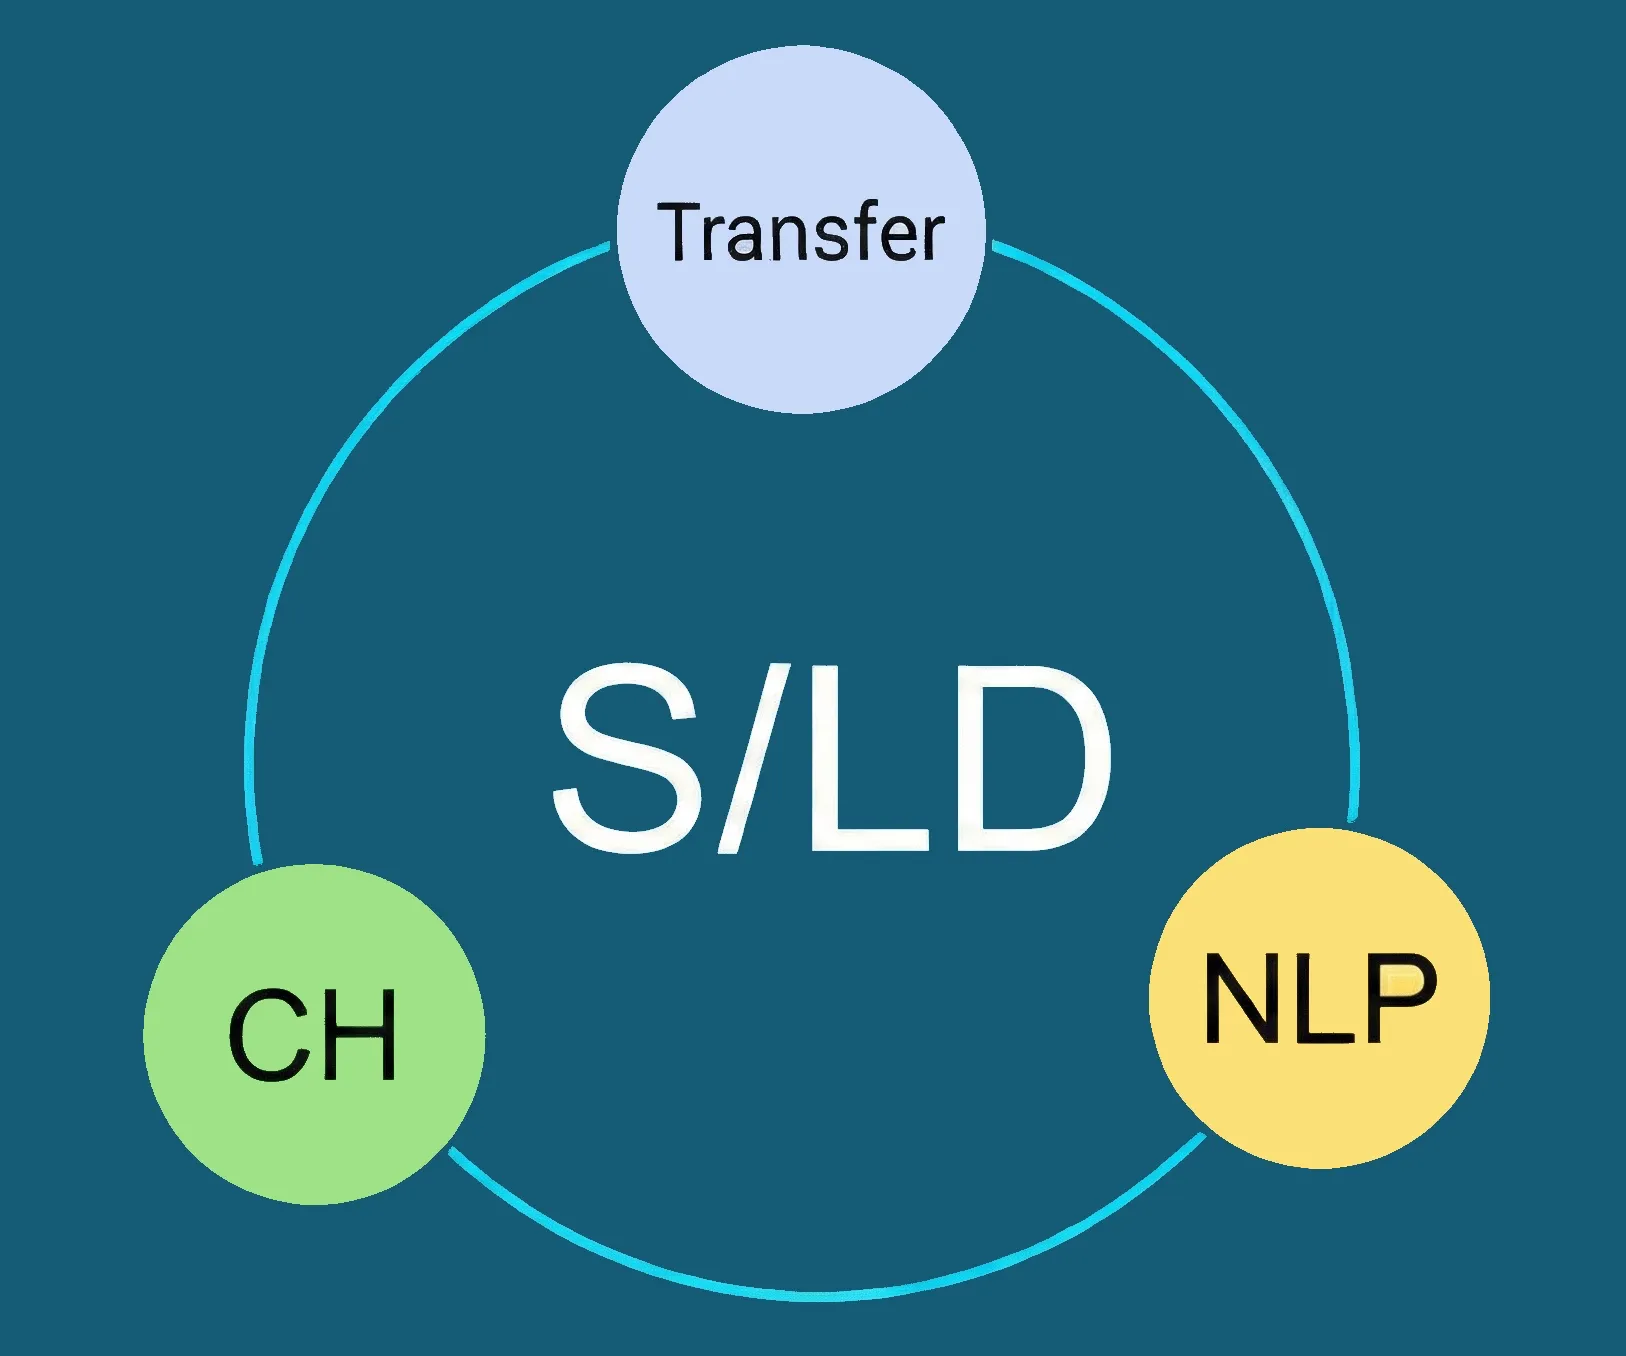
Das gemeinsame Arbeitsprogramm von SILD ist in einem zyklischen Arbeitsablauf von drei interagierenden Projektgruppen strukturiert. Drei Projekte aus den Computational Humanities (CH) bilden die Grundlage und liefern Korpora aus ressourcenarmen Domänen, Evaluationsdaten und Fachexpertise aus der diachronen Untersuchung des Hongkong-Englisch (Linguistik), des frühneuzeitlichen deutschen Dramas (Literaturwissenschaft) und mittelalterlicher arabisch-lateinischer Wissenschaftsübersetzungen (Philosophie). Drei NLP-Projekte nutzen diese Daten und KGs, um integrierte, stichprobeneffiziente Sprachmodelle und robuste Methoden zur Identifizierung von Einzel- und Mehrwortausdrücken zu entwickeln. Zwei Transfer-Projekte überbrücken die Lücke zwischen NLP und CH, indem sie Werkzeuge der visuellen Analytik zur Exploration und Interpretierbarkeit der Modelle schaffen und ein Metamodell des semantischen Wandels zur Steuerung der Bedeutungsanalyse und der Evaluation entwickeln.
Das Projekt wird wertvolle, frei zugängliche Ressourcen hervorbringen, darunter annotierte Korpora, linguistische KGs, Evaluationsdatensätze und domänenadaptierte LLMs sowie neue Methoden zur Erstellung, Analyse und Visualisierung von LLMs für leistungsstarke semantische Analysen in ressourcenarmen Domänen. Damit leistet das Projekt Pionierarbeit durch neue computergestützte Methoden und aktuelle Modelle für ein neues, anwendungsorientiertes Paradigma in den Computational Humanities.
Projektpartner
Finanzierung
Deutsche Forschungsgemeinschaft
Deutsche Forschungsgemeinschaft (DFG)